

Actualizado el 13 de noviembre de 2026 a las 00:45 UTC (18:45 del 12 de noviembre, hora del centro de México). Incidente en curso: en su actualización de las 00:08 UTC Microsoft reporta que los servidores que vuelve a poner en servicio se quedan sin responder otra vez cuando reciben tráfico, por lo que está limitando tipos de tráfico y reconstruyendo parte de los servidores con una configuración de software anterior. El estado oficial sigue siendo «degradación del servicio». Próxima actualización oficial: 01:30 UTC. Al final del artículo hay una bitácora de estado que actualizamos cada 30 minutos.
Qué está pasando
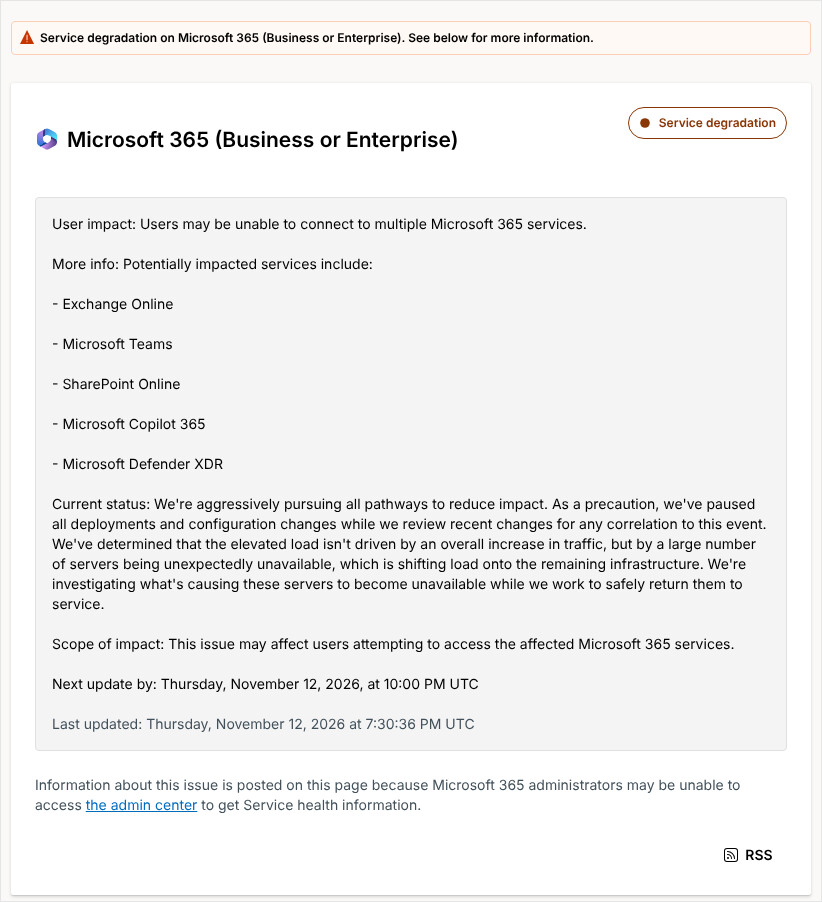
Desde alrededor del mediodía de este jueves 12 de noviembre, usuarios de Microsoft 365 en México, Estados Unidos y otros países reportan problemas para abrir su correo en Outlook, enviar y recibir mensajes y usar Teams, Copilot y otros servicios. Microsoft lo confirmó en su cuenta oficial de estado y en su página pública de salud del servicio, donde al cierre de esta nota aparece como «Service degradation» (degradación del servicio) para Microsoft 365 Business y Enterprise.
Según la página oficial de estado (actualizada por Microsoft a las 00:08 UTC del 13 de noviembre), los servicios potencialmente afectados son:
- Exchange Online (el servicio de correo detrás de Outlook)
- Microsoft Teams
- SharePoint Online
- Microsoft Copilot 365
- Microsoft Defender XDR y Defender for Office 365
- Microsoft Planner y Microsoft To Do
- Microsoft Intune
- Microsoft Purview (autorización, etiquetado automático, prevención de pérdida de datos, cumplimiento de comunicaciones y clasificación de datos)
- Power BI (exportación a PDF de reportes con etiquetas de confidencialidad, de forma intermitente)
- Centro de administración de Microsoft 365 Apps (Cloud Update, Cloud Policy e inventario)
- Universal Print (errores al enviar trabajos de impresión o usar funciones de administración)
- Windows 365 (tenants que usan Customer Key de Purview para sus Cloud PC pueden tener usuarios sin poder conectarse a ellas)
La lista ha ido creciendo: en la actualización de las 19:30 UTC solo aparecían los primeros cinco servicios; la de las 22:11 UTC sumó siete más, la de las 23:06 UTC agregó Universal Print y la de las 00:08 UTC, Windows 365.
Microsoft identifica el incidente como EX1550543 (Exchange Online) y MO1550821 (Microsoft 365) en el centro de administración. Como parte del problema, algunos administradores no han podido entrar al propio centro de administración, por lo que Microsoft está publicando las actualizaciones en su página pública de estado.
Qué dice Microsoft
El primer aviso oficial, publicado en la cuenta Microsoft 365 Status, decía: «Estamos investigando reportes de usuarios con problemas para acceder a buzones de Exchange Online a través de múltiples métodos de conexión en América. Más detalles en el centro de administración de Microsoft 365 bajo EX1550543». Más tarde la empresa amplió el alcance: el problema puede afectar a usuarios de Microsoft 365 en cualquier región.
La actualización de las 19:30 UTC en la página oficial de estado explicaba la causa inmediata y las primeras acciones. Traducción nuestra del texto original en inglés:
Impacto: los usuarios pueden no poder conectarse a varios servicios de Microsoft 365.
Estado actual: «Estamos siguiendo agresivamente todas las vías para reducir el impacto. Como precaución, pausamos todos los despliegues y cambios de configuración mientras revisamos los cambios recientes en busca de alguna correlación con este evento. Determinamos que la carga elevada no se debe a un aumento general del tráfico, sino a que un gran número de servidores quedó inesperadamente no disponible, lo que traslada la carga a la infraestructura restante. Estamos investigando qué provoca que estos servidores dejen de estar disponibles mientras trabajamos para devolverlos al servicio de forma segura».
En otras palabras: no es que haya más gente usando el correo, sino que una parte importante de los servidores que atienden Exchange Online dejó de responder, y los que quedan no dan abasto.
La actualización de las 22:11 UTC (16:11 hora del centro de México) fue menos optimista y dio un poco más de detalle técnico. Traducción nuestra:
Estado actual: «Seguimos explorando todas las vías disponibles para restablecer el servicio, ya que las acciones tomadas hasta ahora no han dado el alivio previsto. Nuestra investigación encontró que un proceso central en los servidores afectados se satura, lo que provoca que los servidores dejen de responder y contribuye a la pérdida de capacidad. Para validar un posible enfoque de recuperación, estamos aislando por completo una parte de nuestra infraestructura de servicio, reiniciando los componentes afectados y reintroduciendo el tráfico de forma gradual para confirmar que los servicios se mantienen estables antes de aplicar este enfoque de manera más amplia. También estamos analizando los patrones de tráfico en toda nuestra infraestructura y evaluando si aislar el tráfico dentro de cada región permitiría que las regiones afectadas se recuperen de forma independiente».
Estado previo: «Seguimos reiniciando y validando los servidores afectados para devolverlos al servicio de forma segura, y exploramos oportunidades para acelerar este proceso. En paralelo, evaluamos si revertir el pequeño número de actualizaciones de configuración recientes que identificamos podría ayudar a acelerar la recuperación».
En esa actualización Microsoft admitió que reiniciar servidores no había bastado, ubicó el problema en un proceso central que se satura dentro de esos servidores, anunció una prueba de recuperación por partes (aislar un segmento, reiniciarlo y volver a meterle tráfico poco a poco) y contempló aislar el tráfico por región. También identificó «un pequeño número de actualizaciones de configuración recientes» que podría revertir, sin afirmar que sean la causa.
La actualización de las 23:06 UTC (17:06 hora del centro de México) trajo las primeras señales de mejora. Traducción nuestra:
Estado actual: «Comenzamos a devolver al servicio una parte de los servidores afectados y hasta ahora se mantienen estables. También desviamos tráfico y conexiones a rutas alternativas donde fue posible y hemos observado una recuperación limitada en algunas regiones. Simplificamos nuestro proceso de recuperación para acelerar el regreso al servicio de los servidores afectados restantes. Para apoyar la recuperación, estamos implementando medidas de protección de gestión de tráfico en una ubicación específica para reducir la carga sobre la infraestructura afectada, y las ampliaremos a más ubicaciones si observamos resultados positivos. Conforme se restablezca la capacidad, los usuarios pueden experimentar una recuperación gradual a medida que sus clientes se reconecten al servicio».
La actualización de las 00:08 UTC del 13 de noviembre (18:08 del 12 de noviembre, hora del centro de México), la más reciente al cierre de esta versión, matiza ese avance. Traducción nuestra:
Estado actual: «Aunque los servidores que devolvimos al servicio se mantienen sanos al inicio, observamos que pueden volver a dejar de responder una vez que empiezan a recibir tráfico. Estamos analizando los datos de diagnóstico de estos servidores con nuestros expertos en redes y plataforma para determinar qué desencadena este comportamiento. Además de las medidas de protección de gestión de tráfico que implementamos, estamos limitando temporalmente qué tipos de tráfico pueden llegar a la infraestructura afectada en ubicaciones específicas. Esto nos ayudará a determinar si un tipo particular de solicitud contribuye al impacto y nos permitirá restablecer el servicio de forma incremental. Adicionalmente, estamos reconstruyendo un subconjunto de los servidores afectados con una configuración de software anterior para validar si eso evita que dejen de responder, y ampliaremos este enfoque a más servidores si observamos resultados positivos».
Próxima actualización: viernes 13 de noviembre de 2026, 01:30 UTC.
Lo nuevo: la recuperación no es lineal. Los servidores reparados vuelven a caer bajo carga, así que Microsoft ahora prueba dos cosas en paralelo: filtrar tipos de tráfico para encontrar si una clase de solicitud es la que los tumba, y reconstruir servidores con la versión de software anterior, lo que sugiere que un cambio reciente de software o configuración está entre los sospechosos. Sigue sin haber hora de restablecimiento total.
Afectaciones para los usuarios
Microsoft describe el impacto de forma general: «los usuarios pueden no poder conectarse a varios servicios de Microsoft 365». En la práctica, por los reportes de usuarios y por cómo dependen entre sí estos servicios, esto es lo que una persona puede estar viendo hoy en su trabajo. No todos los usuarios ni todos los tenants presentan los mismos síntomas, y la falla es intermitente: lo que no funciona en un momento puede funcionar minutos después.
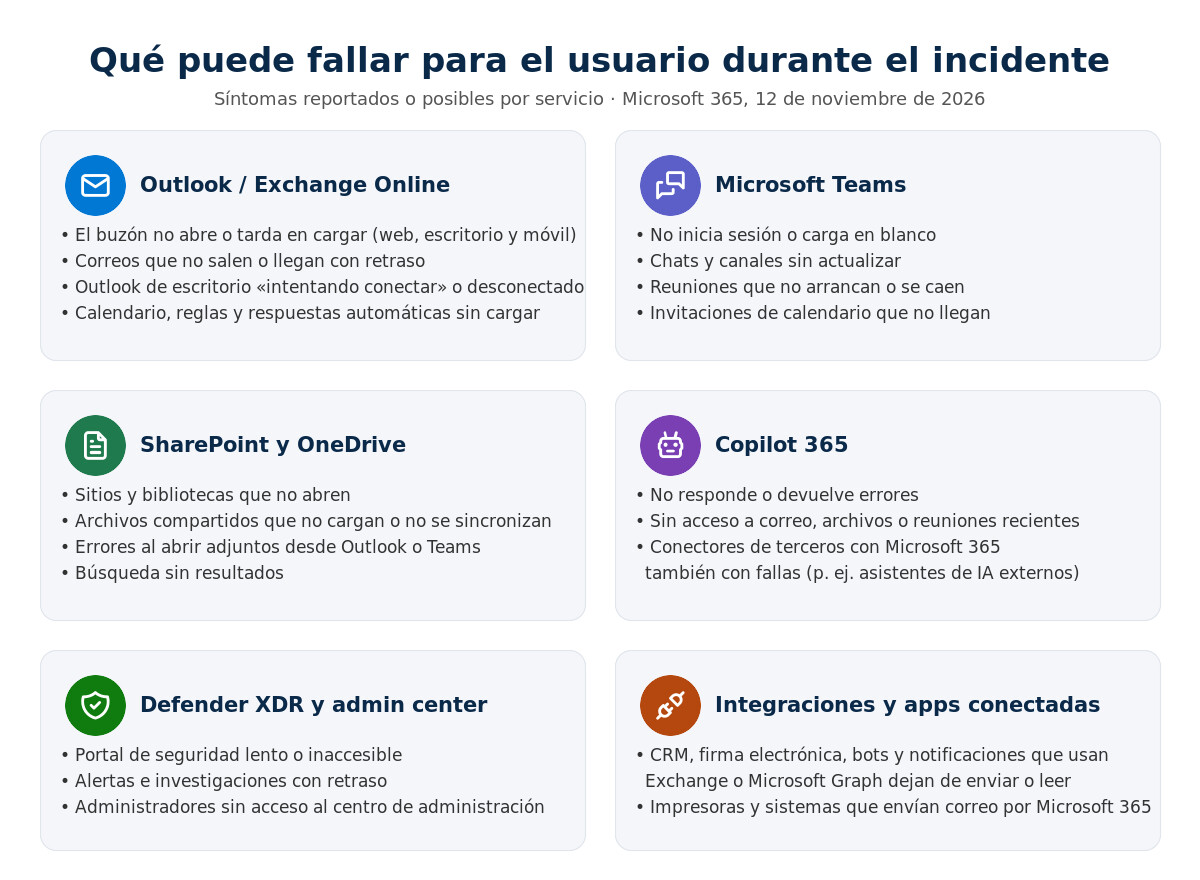
- Correo (Outlook / Exchange Online). Es el servicio con más reportes. El buzón no abre o tarda en cargar en Outlook web, en el cliente de escritorio y en el teléfono; los correos no salen, se quedan en la bandeja de salida o llegan con retraso; Outlook de escritorio se queda en «intentando conectar»; el calendario, las reglas y las respuestas automáticas no cargan. Microsoft menciona fallas «a través de múltiples métodos de conexión», es decir, no basta con cambiar de la app al navegador.
- Teams. Inicio de sesión que no termina o pantalla en blanco, chats y canales que no se actualizan, reuniones que no arrancan o se caen, e invitaciones de calendario que no llegan porque dependen de Exchange.
- SharePoint y OneDrive. Sitios y bibliotecas que no abren, archivos compartidos que no cargan o no sincronizan, adjuntos que no se abren desde Outlook o Teams y búsquedas sin resultados.
- Copilot 365. No responde o devuelve errores, y pierde el contexto de correo, archivos y reuniones porque esos datos vienen de los servicios afectados. Medios reportan que conectores de terceros con Microsoft 365, como los de asistentes de IA externos, también presentan fallas.
- Defender XDR y centro de administración. El portal de seguridad puede estar lento o inaccesible y las alertas e investigaciones pueden retrasarse. Algunos administradores no pueden entrar al centro de administración de Microsoft 365, lo que les impide ver el estado del servicio de su propio tenant; por eso Microsoft publica las actualizaciones en su página pública.
- Integraciones y sistemas conectados. Todo lo que usa Exchange Online o Microsoft Graph para enviar o leer correo (CRM, firma electrónica, bots, portales que mandan notificaciones, impresoras y escáneres que envían por Microsoft 365) puede quedar detenido o acumular colas, aunque la aplicación en sí esté funcionando.
Para el negocio, el efecto más común es la interrupción de comunicación interna y con clientes: correos y citas que no llegan, reuniones que se reprograman, y procesos que dependen de una notificación por correo (aprobaciones, pedidos, tickets) que se quedan esperando. Conviene identificar hoy cuáles de esos procesos se detuvieron para revisarlos cuando el servicio regrese.
Cronología (horas en UTC y en hora del centro de México)
- ~17:45 UTC (11:45 CDMX). Comienzan a crecer los reportes de usuarios en Downdetector; medios estadounidenses registran miles de reportes en pocos minutos. Un panel de estado de terceros muestra el incidente EX1550543 abierto a las 17:46 UTC con el título «Users may be unable to connect to their mailboxes in Exchange Online through multiple connection methods».
- ~18:08 UTC (12:08 CDMX). Microsoft 365 Status publica el primer aviso en X sobre Exchange Online «en América».
- Después de las 18:30 UTC. Microsoft amplía el alcance a cualquier región, señala carga elevada en parte de la infraestructura, redistribuye tráfico y reinicia servidores afectados, según actualizaciones recogidas por medios especializados.
- 19:30 UTC (13:30 CDMX). Actualización en la página oficial de estado: despliegues pausados, servidores inesperadamente no disponibles, investigación en curso.
- Entre 19:30 y 22:11 UTC. Microsoft reinicia y valida servidores afectados y evalúa revertir un pequeño número de cambios de configuración recientes (estado previo citado en la actualización de las 22:11).
- 22:11 UTC (16:11 CDMX). Nueva actualización oficial: las acciones no han dado el alivio esperado; un proceso central de los servidores se satura; prueba de recuperación aislando una parte de la infraestructura; la lista de servicios afectados crece a doce (incluye Intune, Purview, Planner, To Do, Defender for Office 365, Power BI y el centro de administración de Apps).
- 23:06 UTC (17:06 CDMX). Actualización oficial: una parte de los servidores vuelve al servicio y se mantiene estable; tráfico desviado a rutas alternativas; «recuperación limitada en algunas regiones»; medidas de protección de tráfico en una ubicación específica; recuperación gradual prevista. Se agrega Universal Print a la lista de servicios afectados.
- 13 de noviembre, 00:08 UTC (18:08 CDMX del 12 de noviembre). Actualización oficial: los servidores reparados vuelven a dejar de responder al recibir tráfico; Microsoft limita tipos de tráfico en ubicaciones específicas y reconstruye parte de los servidores con una configuración de software anterior. Se agrega Windows 365 a la lista de servicios afectados.
- 13 de noviembre, 01:30 UTC (19:30 CDMX). Hora prometida por Microsoft para la siguiente actualización.
Las cifras de Downdetector (más de 4 mil reportes citados por UnoTV; decenas de miles en Estados Unidos según medios de ese país) son reportes de usuarios, no un conteo de afectados, y varían mucho entre fuentes. Lo que sí está confirmado por Microsoft es el estado de degradación y la lista de servicios anterior.
Lo que todavía no se sabe
- La causa de fondo. Microsoft ha dicho que un proceso central de los servidores afectados se satura y los deja sin responder, que identificó un pequeño número de cambios de configuración recientes que podría revertir y que está reconstruyendo servidores con una configuración de software anterior para probar si eso los estabiliza. No ha confirmado que esos cambios sean la causa, no ha mencionado un ataque ni una falla de hardware, y nosotros tampoco lo afirmamos.
- La hora de restablecimiento. No hay una estimación oficial. A las 22:11 UTC Microsoft reconoció que lo hecho hasta entonces no había dado el alivio esperado; a las 23:06 UTC reportó recuperación limitada en algunas regiones; a las 00:08 UTC admitió que los servidores reparados vuelven a caer bajo tráfico. El servicio sigue intermitente: hay usuarios que pueden entrar y otros que no, y eso puede cambiar de un minuto a otro.
- El alcance exacto. Empezó como «América» y ahora es «cualquier región». No hay cifras oficiales de usuarios o tenants afectados.
Qué hacer mientras dura la falla
Para equipos de TI y personas responsables de la operación:
- No es un problema de contraseñas ni de MFA. Si un usuario no puede entrar a Outlook, no restablezcas su contraseña ni reconfigures su autenticación: el síntoma viene del servicio, no de la cuenta. Eso solo agrega trabajo y confusión cuando el servicio regrese.
- Consulta el estado oficial. Si no puedes entrar al centro de administración, usa la página pública status.cloud.microsoft o la cuenta Microsoft 365 Status en X. Evita basarte solo en Downdetector.
- Avisa a tu gente. Un mensaje corto por un canal que no dependa de Microsoft 365 (WhatsApp, teléfono, otro correo) evita cientos de reportes al soporte interno: «Microsoft tiene una falla global en Outlook y Teams; no es tu equipo ni tu cuenta; te avisamos cuando se normalice».
- No hagas cambios en tu tenant. Igual que Microsoft pausó sus despliegues, evita cambios de configuración, migraciones o reglas de correo hasta que el servicio esté estable. Es difícil distinguir un error propio de uno del proveedor en medio de una falla.
- Ten paciencia con el correo. Los mensajes enviados durante la falla normalmente quedan en cola y se entregan después; no reenvíes el mismo correo varias veces. Si usas un relevo SMTP propio o un filtro de correo externo, revisa sus colas cuando el servicio regrese.
- Cuidado con el phishing oportunista. Las fallas masivas se aprovechan para enviar correos y mensajes del tipo «tu cuenta de Microsoft fue suspendida, verifica aquí». Microsoft no pide credenciales por esa vía.
- Después del incidente, revisa que los flujos críticos hayan regresado (correo entrante y saliente, reuniones de Teams, integraciones y conectores que dependen de Exchange o Graph) y anota qué procesos de tu operación se detuvieron: es el insumo para tu plan de continuidad.
¿Cómo te ayudamos en StackFire?
Si tu operación depende de Microsoft 365 y hoy te quedaste sin correo o sin Teams, en StackFire te ayudamos a verificar el estado de tu tenant cuando el servicio regrese, a revisar colas y conectores, y a diseñar un plan de continuidad realista: canales alternos de comunicación, respaldo de correo y documentos fuera del proveedor, y una guía de qué hacer (y qué no) durante una falla del proveedor. Escríbenos desde la página de contacto.
Fuentes
- Microsoft, Service Health Status: entrada «Microsoft 365 (Business or Enterprise) – Service degradation», actualizaciones del 12 de noviembre de 2026 a las 19:30, 22:11 y 23:06 UTC y del 13 de noviembre a las 00:08 UTC (consultada por última vez a las 00:40 UTC).
- Microsoft 365 Status en X, aviso inicial sobre Exchange Online (EX1550543), 12 de noviembre de 2026.
- UnoTV, Microsoft se cae: reportan fallas en Outlook, Teams y Copilot este jueves 12 de noviembre, 12 de noviembre de 2026, 12:59.
- WGCU, Outage reported nationwide for Outlook email service; Microsoft confirms problem, 12 de noviembre de 2026, 13:29 EST.
- WindowsForum, cronología del incidente EX1550543, 12 de noviembre de 2026 (actualizado 15:25 EST). Fuente secundaria: recopila actualizaciones de otros medios.
Bitácora de estado
Revisamos la página oficial de estado de Microsoft cada 30 minutos y anotamos aquí lo que dice, de lo más reciente a lo más antiguo. Horas en UTC y en hora del centro de México (CDMX).
- 13 nov, 00:40 UTC (18:40 CDMX, 12 nov). Estado oficial: degradación del servicio. Última actualización de Microsoft a las 00:08 UTC: los servidores devueltos al servicio vuelven a dejar de responder al recibir tráfico; se limitan tipos de tráfico en ubicaciones específicas y se reconstruye parte de los servidores con una configuración de software anterior. Catorce servicios en la lista (se agrega Windows 365). Próxima actualización oficial: 01:30 UTC.
- 12 nov, 23:39 UTC (17:39 CDMX). Estado oficial: degradación del servicio. Actualización de Microsoft de las 23:06 UTC: una parte de los servidores vuelve al servicio y se mantiene estable; tráfico desviado a rutas alternativas; «recuperación limitada en algunas regiones»; recuperación gradual prevista. Se agrega Universal Print.
- 12 nov, 22:14 UTC (16:14 CDMX). Estado oficial: degradación del servicio. Actualización de Microsoft de las 22:11 UTC: las acciones no han dado el alivio esperado; un proceso central de los servidores se satura; prueba de recuperación aislando parte de la infraestructura. La lista de servicios crece a doce.
- 12 nov, 20:28 UTC (14:28 CDMX). Estado oficial: degradación del servicio. Actualización de Microsoft de las 19:30 UTC: despliegues pausados; la carga elevada se debe a un gran número de servidores inesperadamente no disponibles. Cinco servicios en la lista: Exchange Online, Teams, SharePoint Online, Copilot 365 y Defender XDR.
- 12 nov, ~18:08 UTC (12:08 CDMX). Primer aviso oficial en la cuenta Microsoft 365 Status: investigación de problemas de acceso a buzones de Exchange Online en América (EX1550543).